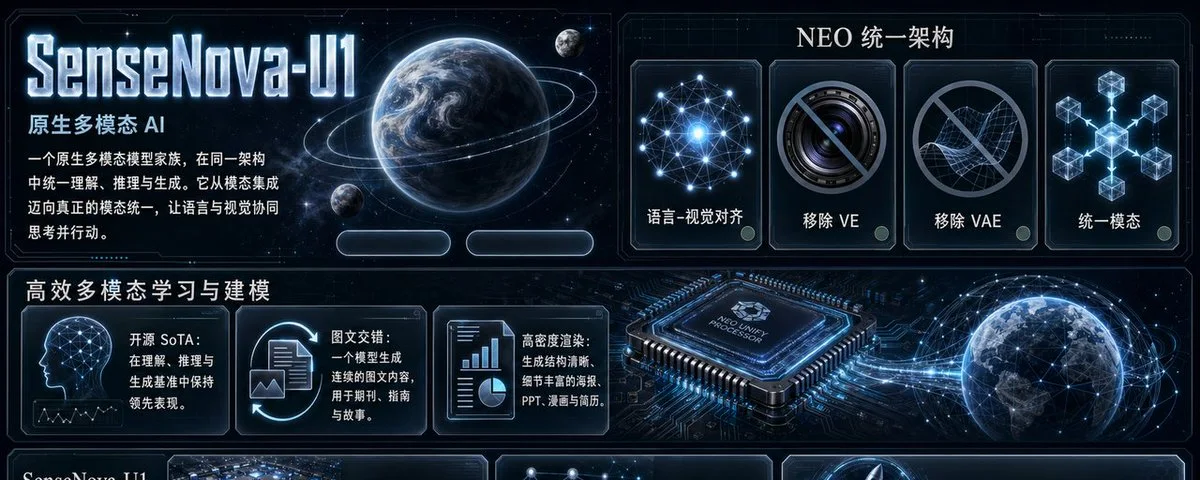
开源生图模型正在从“谁画得更好看”,走向“谁更懂结构”。SenseNova U1-8B-MoT-Infographic 瞄准的是海报、图表、教程页、论文风页面这类最容易翻车的图文场景。10B 以下的小模型,能不能把理解、排版和生成合在一起?这篇文章聊聊 U1 这次真正有意思的地方。
商汤这周给 SenseNova U1 补了一块很关键的拼图:SenseNova-U1-8B-MoT-Infographic。
如果说前一版 U1 讲的是“原生 unified multimodal 模型”这条路线能不能跑通,这个 Infographic 版本更像是把能力压到一个清晰场景里:海报、图表、食谱卡片、明信片、教程页,甚至 arXiv 风格页面这种高密度视觉内容。
这个方向值得看,原因不在模型规模和单项分数,而在它的架构选择。
U1 走的是 NEO-unify:去掉传统视觉编码器 VE 和 VAE,让模型在更原生的结构里统一理解、推理和生成。开源 unified 模型过去常见路线是把图像压成离散 token,再交给 LLM 处理,训练框架省事,但密集文字、版式细节、跨图一致性很容易被压没。U1 的思路更激进,尽量绕开这类压缩瓶颈,用 MoT 把理解和生成路径解耦,同时保持跨模态信息流通。
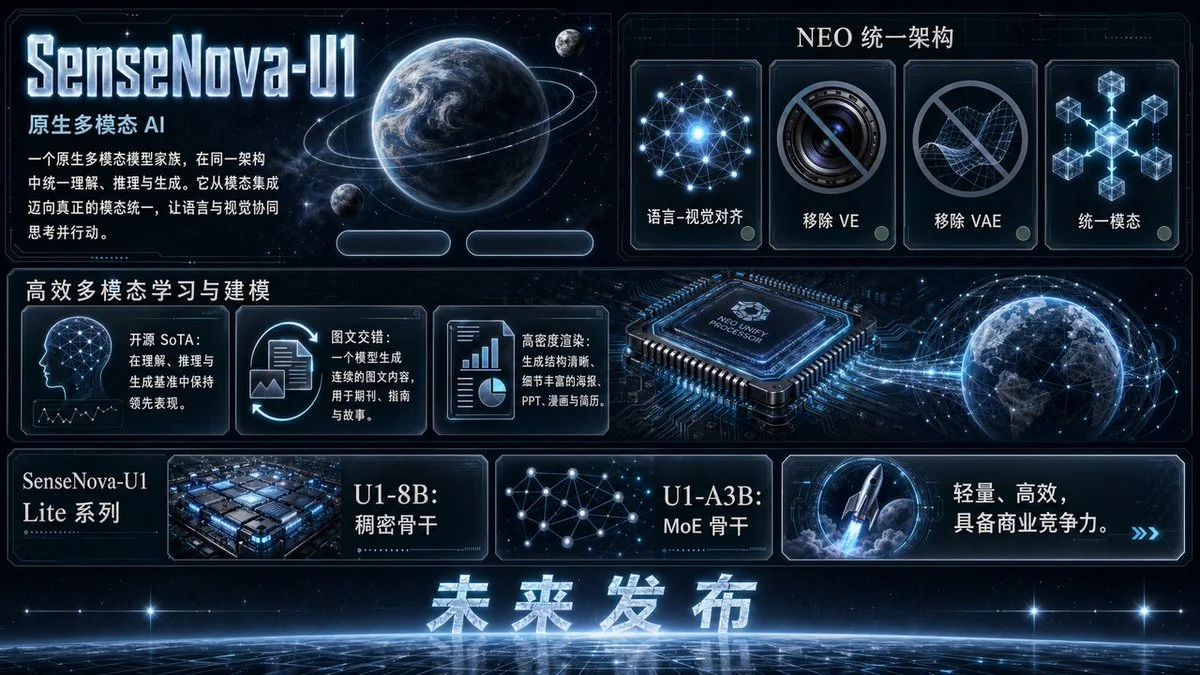
这也解释了为什么 Infographic 版本有意义。
信息图生成考验的不是单纯画质,而是“先理解结构,再组织视觉表达”:标题层级、正文密度、图表关系、图文对应、局部小字,都得同时在线。GitHub 最新信息里,SenseNova-U1-8B-MoT-Infographic 是 2026.05.15 发布的专门增强版,官方给了 100 多个展示案例。模型卡显示,它相对基础版 U1-8B-MoT:
-
BizGenEval hard:39.8 提到 46.6,+6.8
-
BizGenEval easy:61.1 提到 65.4,+4.3
-
IGenBench Q-ACC:51.3 提到 69.5,+18.2
-
IGenBench I-ACC:4.2 提到 17.0,+12.8
这个提升很对路。U1 原本就更适合“理解 + 生成协同”的任务,Infographic 版本等于把优势进一步压到结构化视觉内容上。对设计师、自媒体、科研工作者来说,它更像一个能快速起草复杂版面的开源工具:海报、知识卡片、论文风格页面、教程图、产品说明图,都属于它的甜点区。
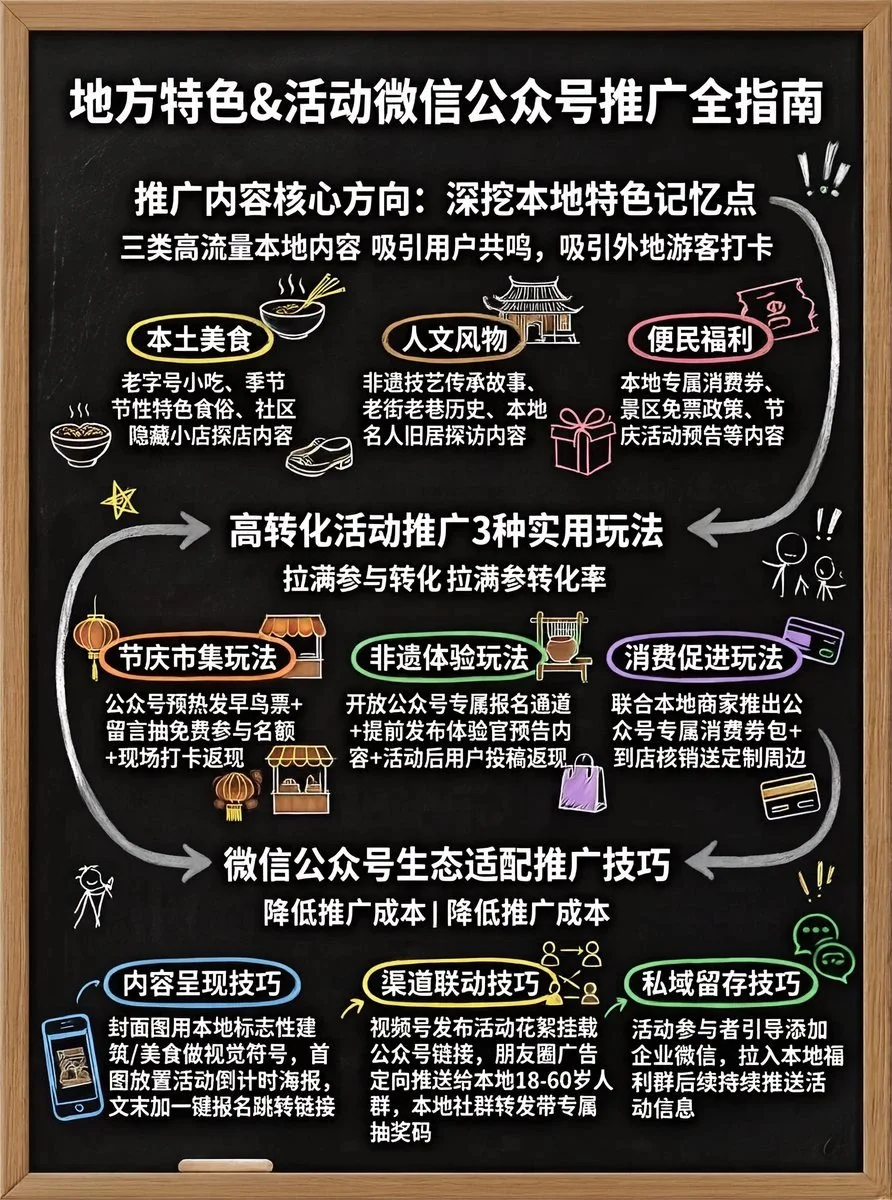
生图提示词:
该信息图以黑板风格设计,标题为“地方特色&活动微信公众号推广全指南”,整体采用手绘粉笔字效果,配以彩色图标和箭头,视觉上模拟真实黑板书写场景。内容结构清晰,分为三个主要部分,通过灰色弧形箭头连接,形成逻辑递进关系:从推广内容核心方向 → 高转化活动推广玩法 → 微信公众号生态适配推广技巧。

第一部分:“推广内容核心方向:深挖本地特色记忆点”,强调通过三类高流量本地内容吸引用户共鸣并吸引外地游客打卡:
- **本土美食**(黄色椭圆标签):包含老字号小吃、季节性特色食俗、社区隐藏小店探店内容,配有热汤碗与筷子图标。
- **人文风物**(棕色椭圆标签):涵盖非遗技艺传承故事、老街老巷历史、本地名人旧居探访内容,配有传统建筑与布鞋图标。
- **便民福利**(粉色椭圆标签):包括本地专属消费券、景区免票政策、节庆活动预告等内容,配有优惠券与礼盒图标。

第二部分:“高转化活动推广3种实用玩法”,旨在拉满参与转化率:
- **节庆市集玩法**(橙色椭圆标签):公众号预热发早鸟票+留言抽免费参与名额+现场打卡返现,配有灯笼与摊位图标。
- **非遗体验玩法**(绿色椭圆标签):开放公众号专属报名通道+提前发布体验官预告内容+活动后用户投稿返现,配有陶艺与织布机图标。
- **消费促进玩法**(紫色椭圆标签):联合本地商家推出公众号专属消费券包+到店核销送定制周边,配有购物袋与银行卡图标。

第三部分:“微信公众号生态适配推广技巧”,聚焦降低推广成本:
- **内容呈现技巧**(蓝色椭圆标签):封面图用本地标志性建筑/美食做视觉符号,首图放置活动倒计时海报,文末加一键报名跳转链接,配有手机图标。
- **渠道联动技巧**(黄色椭圆标签):视频号发布活动花絮挂载公众号链接,朋友圈广告定向推送给本地18-60岁人群,本地社群转发带专属抽奖码,配有三人社交网络图标。
- **私域留存技巧**(绿色椭圆标签):活动参与者引导添加企业微信,拉入本地福利群后续持续推送活动信息,配有微信对话气泡图标。

整个信息图布局呈垂直流线型,各模块之间以曲线箭头连接,右侧点缀有简笔小人和感叹号等装饰元素,增强趣味性和可读性。文字排版层次分明,主标题白色粗体,副标题与核心概念使用黄色或彩色突出,细节说明则为白色常规字体。所有文本均为中文,无英文或其他语言内容。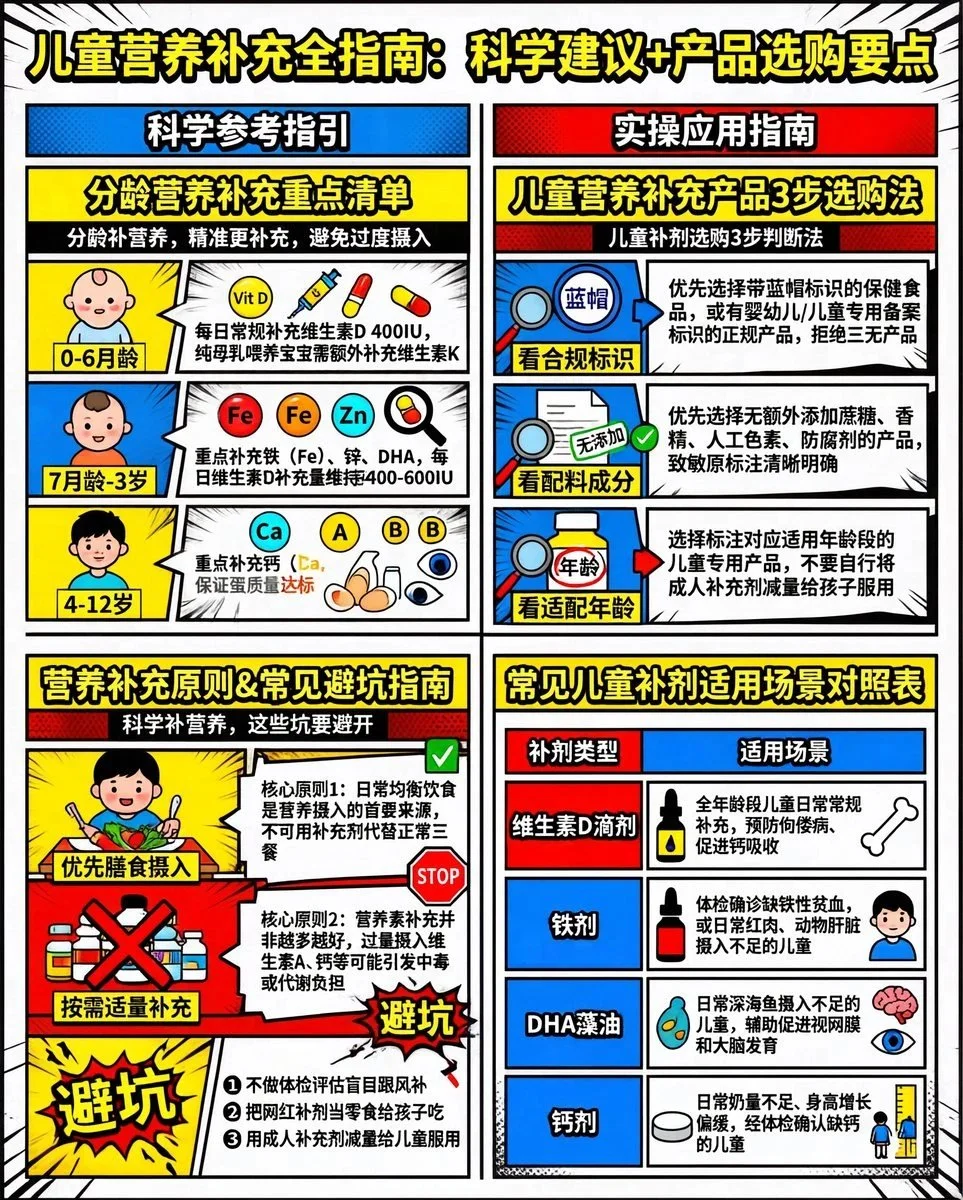
该信息图题为《儿童营养补充全指南:科学建议+产品选购要点》,采用漫画风格设计,色彩鲜明,以红、黄、蓝为主色调,布局清晰分为左右两大板块,每个板块又细分为多个模块,图文并茂地呈现了儿童营养补充的科学指导与实用建议。

整体结构分为“科学参考指引”和“实操应用指南”两大核心部分,通过卡通插图、图标、爆炸式对话框、标签等视觉元素增强可读性与吸引力。
GitHub 这几天也更新得比较密:
-
2026.04.27:首发 U1-8B-MoT / U1-8B-MoT-SFT 权重和推理代码
-
2026.05.06:发布 8-step LoRA
-
2026.05.08:加入 GGUF 量化权重和低显存分层加载模式,Q4 + balanced 被推荐给 10-12GB 消费级显卡
-
2026.05.10:发布 SenseNova-U1 技术报告,并开源 U1-A3B-MoT / U1-A3B-MoT-SFT
-
2026.05.15:发布 U1-8B-MoT-Infographic
所以现在 U1 已经不只是一个技术博客里的架构预览,而是有权重、有推理代码、有技术报告、有在线 Demo,也有专门面向信息图的增强模型。
当然,别把它理解成闭源旗舰画质擂台的替代品。Nano Banana、GPT Image 这类大体量闭源模型在纯画质、审美稳定性、复杂编辑上仍然强很多。
U1 更值得看的地方,是小模型能不能在图文一体、结构化视觉表达、跨模态推理这些垂直场景里打出差异。
我更关心后面两件事:
第一,NEO-unify 在更大模型上能不能继续成立。现在是 Lite 系列,GitHub 也写了后续会有更大规模版本。如果 scale up 后信息图、教程、绘本、图文交错输出还能保持结构优势,开源 unified 路线会很有看头。
第二,理解和生成能不能像模块一样持续迭代。NEO-unify 前作里已经出现过一个有意思的信号:冻结理解分支、只训生成分支,2B preview 仍然能跑出可用编辑能力。U1 如果沿着这条路继续推进,未来 unified 模型的训练可能会更像搭积木:理解能力先打稳,再针对生成、编辑、信息图、交错输出做专项增强。
我跑过一个 6 格水彩连环画 case:主角是穿红色背带裤的胖橘猫 Marshmallow,从看雨到撑伞救麻雀。结果不算惊艳,但角色毛色、背带裤、蓝色雨伞、整体水彩风格基本能跨格保持一致。Midjourney 或 SD 多次独立调用很容易到第三格就漂,U1 一次推理出多图这点,对绘本、教程、连续叙事内容确实有价值。
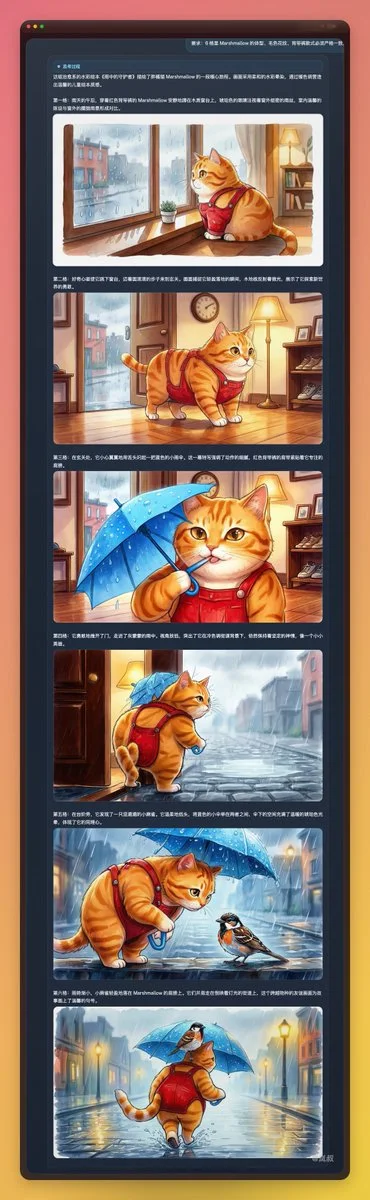
短板也明显。GitHub 里仍然把训练代码列在 ToDo;文字生成在复杂提示下仍可能有拼写、变形和排版不一致;交错生成还是实验特性,官方也提示它还没针对编辑、推理、交错任务做完整 RL 优化。
但这条路线值得关注。开源图像模型过去很卷画质,U1 把重点拉回到“图像能不能成为推理和表达的一部分”。如果未来 multimodal agent 真要处理图、生成图、修改图、解释图,pipeline 拼接方案迟早会遇到结构上限。U1 这种原生 unified 路线,可能才是更长期的方向。
资源:
HuggingFace: https://huggingface.co/sensenova/SenseNova-U1-8B-MoT-Infographic
ModelScope: https://www.modelscope.cn/models/SenseNova/SenseNova-U1-8B-MoT-Infographic
GitHub: https://github.com/OpenSenseNova/SenseNova-U1
技术报告: https://huggingface.co/papers/2605.12500
在线 Demo: https://unify.light-ai.top/
参考核对:GitHub README、HuggingFace 模型卡、HF Papers / arXiv 2605.12500。