X 文章 · 原文写于 2026.05。下文保留当时的记录,工具版本与价格以当前官方信息为准
原题:做企业 AI 视频项目逼出来的工具包:411 prompt · 7 Claude Skill · 14 篇方法论
查看 X 原文 ↗一、起点
最近疯狂做 AI 视频生成和提示词调优,也开发了一个完整的全流程视频生成网站,目前准备给企业用了。开发过程中发现一件事:我缺一份自己用的趁手工具包。每家模型的吃的提示词技巧很不一样、官方文档藏得深、版本迭代快、方法论散落各处,每次接新需求都要重新翻一遍。
某个周末突发奇想,索性做完整 — 不只是收提示词。把市面上主流 AI 视频模型的官方写法 + 实测样本 + Claude Code Skill + 方法论 SOP + 官方资源汇总,一起装进一个 GitHub 仓库。一行 git clone 就能用,做企业项目时挑模型 / 写 prompt / 排查问题都从这里出发。
迭代下来,这个仓库现在的样子是:
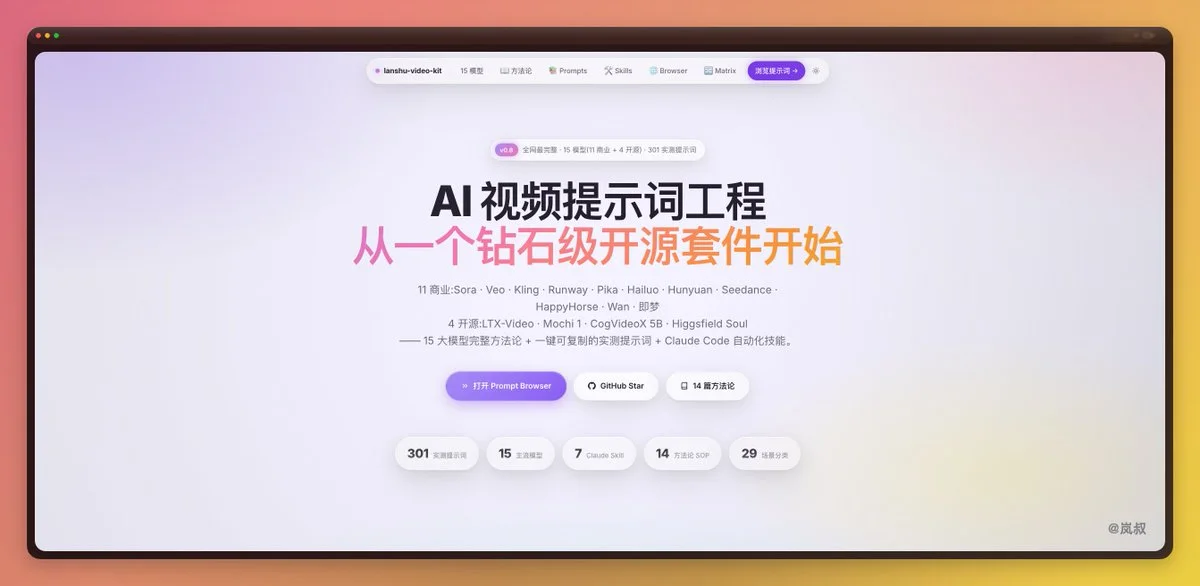
411 条 prompt(301 单模型最佳实践 + 110 跨模型对照) 15 模型(11 商业 + 4 开源) 7 个 Claude Code Skill 14 篇方法论 SOP 29 个场景分类 32 个监控端点(每周一自动巡检) 55+ 文件
二、为什么不是又一个“100 个 prompt 大全”
市面上“AI 视频 prompt 大全”类内容很多,常见的 3 个问题:
来源不明 — 不标谁写的、在哪个模型上测的、成功率如何。 过期失效 — 大量 2024 年的写法在 2026 的模型上跑不出来。 混杂厨房 — 一条 prompt 既不是 Sora 的 Shot List 也不是 Kling 的 5 层公式,只是“看起来高级”。
做仓库时我给自己定了 3 条规矩,分别对着前面 3 个问题。
规矩 1:每条 prompt 必须有 source 字段。 链到原始博客、官方文档、论文。不能写“我编的”。来源权威度区分颜色:火山方舟 53 页 PDF / OpenAI Cookbook / Google DeepMind / Atlabs / 4 大开源仓库官方手册算最高级;Imagine.art / Atlas Cloud 这种测评博客是次一级。
规矩 2:跟模型版本,但不靠人记。 Wan 2.5 升 Wan 2.7、Sora 2 web 端 2026-04-26 停服、Veo 3.1 推出 Lite 版,这些我都记不住。所以写了个 GitHub Action,每周一 09:00 北京时间自动跑。监控 32 个官方端点的 SHA-256 hash,任何端点变了就开 issue。仓库自己醒着。
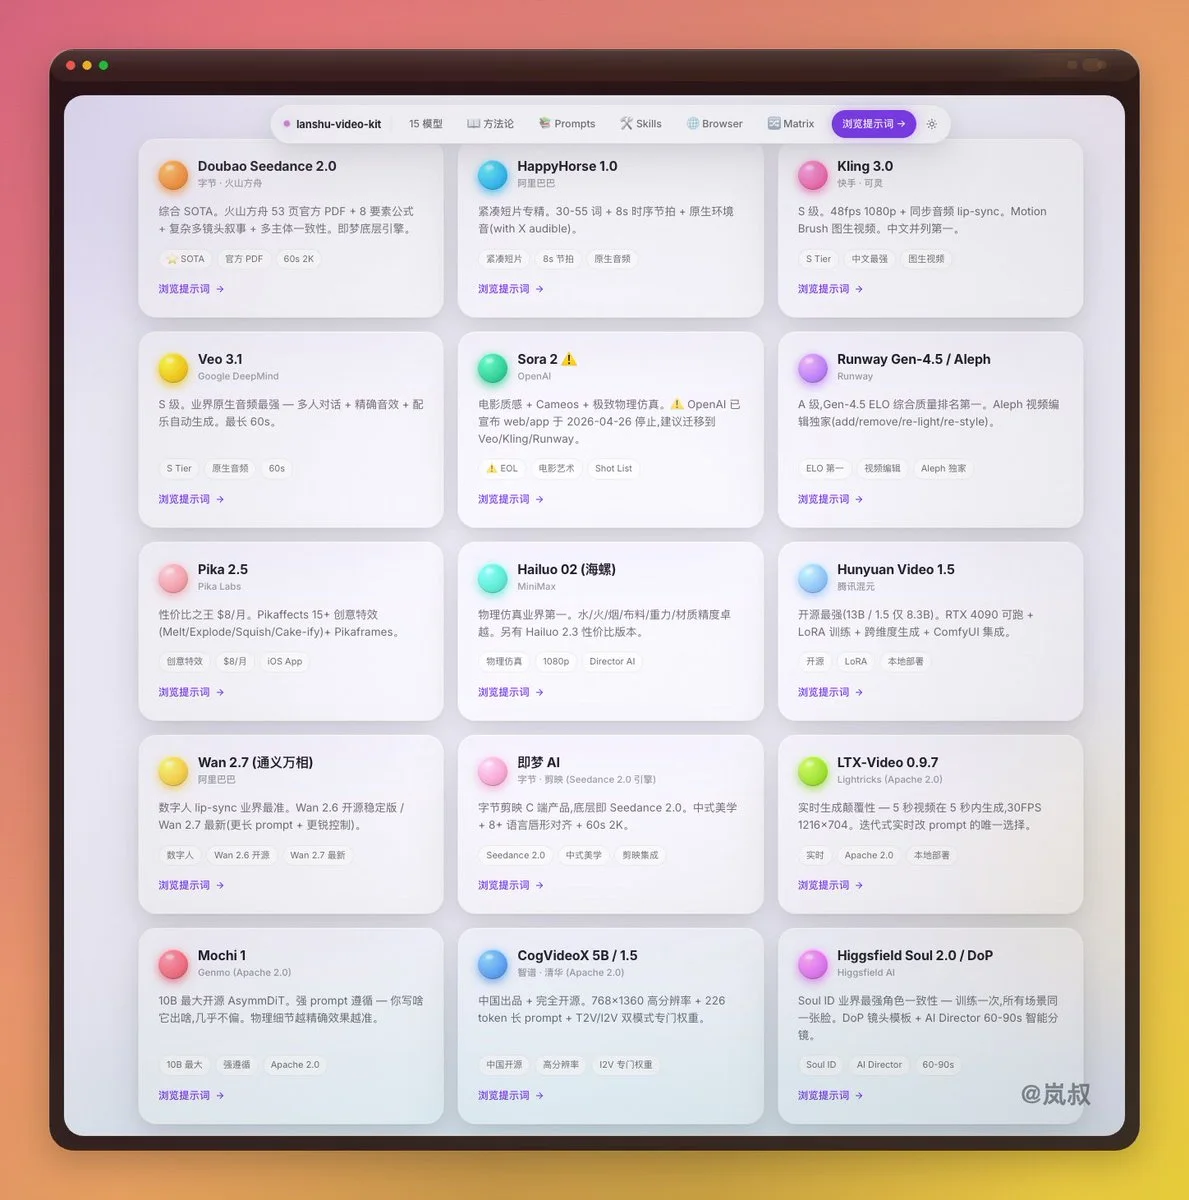
规矩 3:每个模型用自己的官方公式,不互相套。 Sora 是分层 Shot List。Veo 是 8 元素 + Dialogue:/Audio: 双标记。Kling 是 5 层进阶。Seedance 是 8 要素结构化(来源是火山方舟 53 页 PDF)。Wan 是 Entity+Scene+Motion+Sound 四段。每家完全不一样,我也不把它们捏成通用模板。
简单对应一下:source 字段杀来源不明、自动监控杀过期失效、各家公式独立杀混杂厨房。规矩定完之后,所有新加内容都按这 3 条过一遍才进库。
三、7 个 Skill 是怎么提炼的
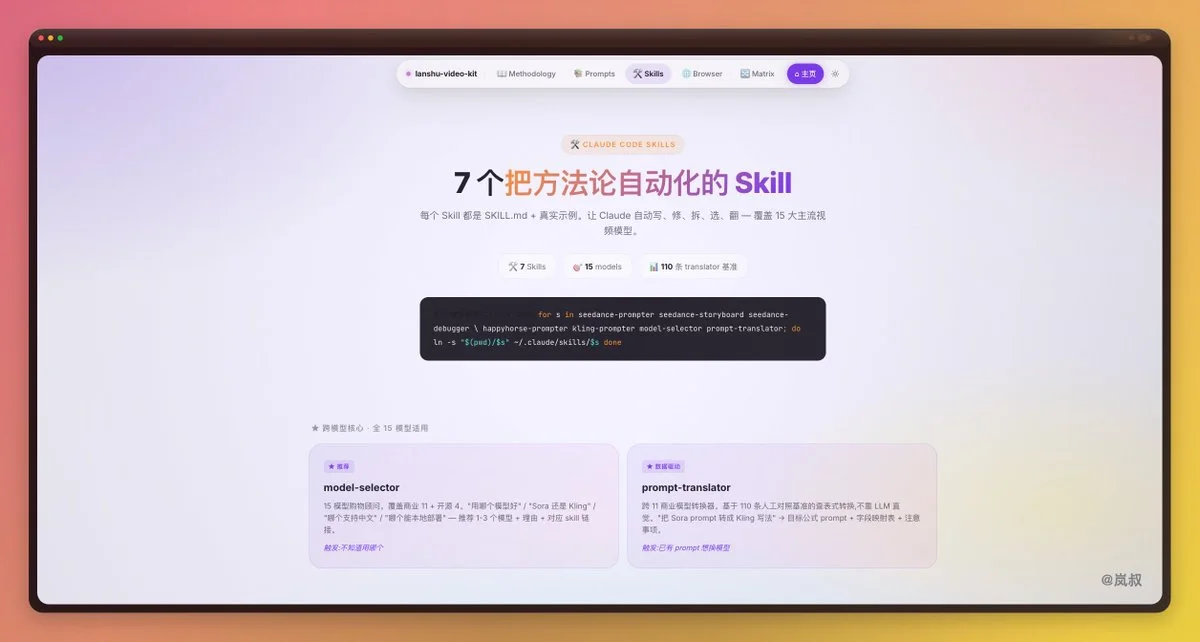
按 Anthropic 官方 SKILL.md 标准,每个 skill 是独立目录 + YAML frontmatter。装到本地 Claude Code 一行:
for s in seedance-prompter seedance-storyboard seedance-debugger
happyhorse-prompter kling-prompter
model-selector prompt-translator; do
ln -s “$(pwd)/skills/$s” ~/.claude/skills/$s
done
7 个 skill 的分工:
Skill触发场景输出model-selector ★“用哪个模型好” / “Sora 还是 Kling” / “哪个能本地部署”推荐 1-3 个模型 + 理由(覆盖全 15 模型)prompt-translator ★“把这条 Sora prompt 转成 Kling 写法”目标模型公式 + 字段映射表seedance-prompter“做个 Seedance 视频”8 要素结构化 promptseedance-storyboard“把剧情拆成分镜”3-5 个分镜 + 4 维度组织seedance-debugger“我的 prompt 出问题了”12 类诊断 + 修复版happyhorse-prompter“5-8 秒紧凑短片”30-55 词 + 原生音频路径kling-prompter“可灵 / 图生视频 / 中文剧情”三套写法自适应
标星的两个是跨模型的,其他 5 个是单模型专属。
Seedance 单独做了 3 个 skill(写/拆/修),是因为那 53 页 PDF 信息密度足够拆出三个独立用法。其他模型材料不够厚,一家一个 prompter 就够。
四、411 条 prompt 怎么组织
411 条不是堆在一个文件里,有结构:
301 条 — 按模型最佳实践收录。每条带 source 字段。具体分布:
模型条数JSON 前缀Seedance 2.064sd-HappyHorse 1.057hh-Kling 3.036kl-Sora 2 / Veo 3.1各 20so- / ve-Runway / Pika / Hailuo / Hunyuan / Wan / 即梦各 12rw- pk- hl- hy-* wn-* jm-LTX / Mochi / CogVideoX / Higgsfield各 8lt- mo-* cg-* hg-*
Seedance 条数明显多,因为有 53 页 PDF 拆出来的细分场景多。其他模型条数大致跟“该模型公开资料的厚度”成正比 — 资料厚我能挖出来的就多,这个原则比“每家一样多”诚实。
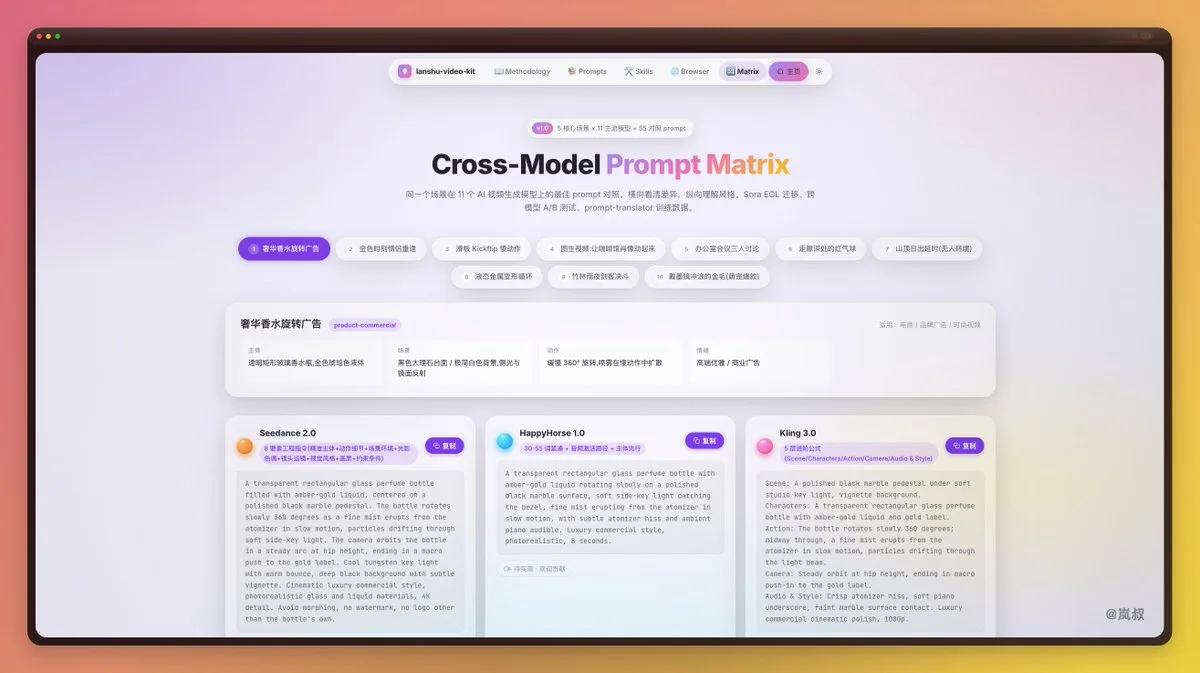
110 条 — 10 场景 × 11 商业模型对照矩阵。同一个“产品广告”场景,在 Sora、Kling、Wan、Seedance…11 个模型上各按对应模型的官方公式手写一条。10 个场景:产品广告 / 双人对话 / 物理动作 / 图生视频 / 多人会议 / 恐怖悬疑 / 自然延时 / 抽象艺术 / 武侠 / 萌宠。
这份矩阵是我自己用得最频繁的一块 — 接到新需求先看场景里 11 家各自怎么写,不是因为我要全跑一遍,而是看完之后选模型这件事直觉就来了。用途三个:
-
横向看清同一需求在 11 个模型上写法的差异
-
prompt-translator skill 的查表基准(不靠 LLM 直觉)
-
预留 effect_video_url 字段,等社区贡献实测视频后,矩阵从文本对照升级为视频对照
29 个场景分类是横向 tag,跨 prompt 类别使用。每条 prompt 至少打 3 个 tag,Web 工具的三维筛选(模型 + 分类 + 标签多选)就靠这个驱动。
五、14 篇方法论 SOP
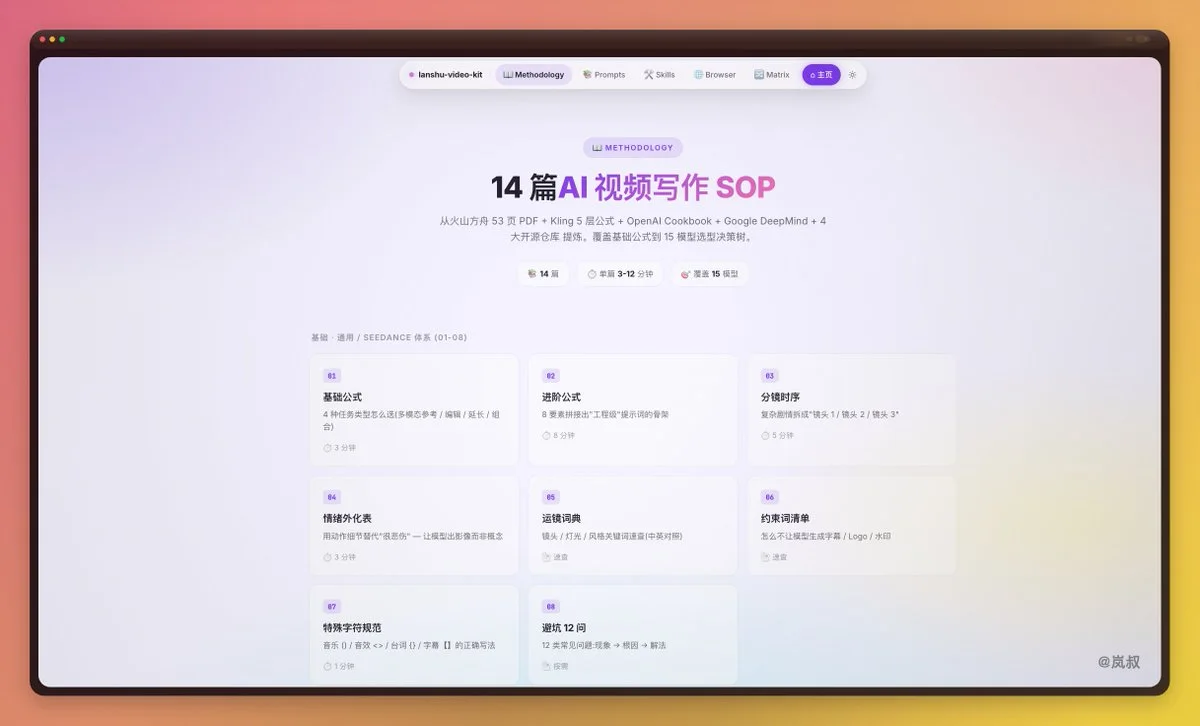
14 篇按主题分四组:
01-08 通用 + Seedance 体系:基础公式 / 进阶 8 要素 / 分镜时序 / 情绪外化表 / 运镜词典 / 约束词清单 / 特殊字符规范 / 避坑 12 问。前 4 篇是导演级写作框架,后 4 篇是工具速查。
09-12 三家独立模型公式:Kling 三套写法 + 6 守则 / 跨 5 模型对比 / Sora 2 分层 Shot List / Veo 3.1 8 元素 + 原生音频 4 层。这 4 篇是因为这 3 家(Kling/Sora/Veo)各自有独特的官方公式,撑得起一篇独立 SOP。
13 六大商业模型速查:Runway / Pika / Hailuo / Hunyuan / Wan / 即梦 一锅端。这 6 家的公式相对简洁,合并一篇 12 分钟读完。
14 四大开源模型速查:LTX / Mochi / CogVideoX / Higgsfield。带 15 模型完整选型决策树(本地部署 vs 商业 API vs 角色一致性 vs 60s 短片 4 个分支)。
如果只挑两篇必读,我选 02 进阶 8 要素(导演级写作框架,理解了所有 prompt 都是它的变体)+ 13 六大商业模型速查(12 分钟拿到 6 个模型的公式,接需求时直接抄)。其他 12 篇按需查。
六、32 个监控端点 + 每周一自动巡检
模型迭代太快,人记不住。所以仓库自己醒着:
.github/workflows/model-version-monitor.yml
schedule:
- cron: ‘0 1 * * 1’ # 每周一 UTC 01:00 = 北京时间 09:00
scripts/monitor_models.py 跑过 32 个端点(每个模型的 GitHub Releases atom / HuggingFace Model Card / 官方 prompt guide),用 SHA-256 hash 比对内容变化。任何端点变了 → 自动开 GitHub Issue,标题写明哪个模型哪个 URL 改了。
噪音过滤靠 model_endpoints.yaml 里的 noise_patterns(timestamp / csrf-token / nonce 那些),不然每次都误报。
前几次版本迭代(Wan 2.5 → 2.7、Sora 2 web 端 2026-04-26 停服、Veo 3.1 推出 Lite 版)我是手动盯着 X 和官方博客同步的,挺累。这套自动监控是 v0.7 才上线的,下一次再有变化时就由它接管 — issue 进 inbox,人工 review 后批量更新 README / 方法论 / Skill 描述。
七、Web 工具部分
整个仓库的网页层都是零依赖单文件 HTML,GitHub Pages 直接跑。8 个页面统一一套 Liquid Glass 主题(mesh 渐变背景 + 浮动胶囊 nav),暗/亮模式 localStorage 跨页同步 — 你在主页切到亮色,跳到 methodology 也是亮色。
3 个核心工具页:
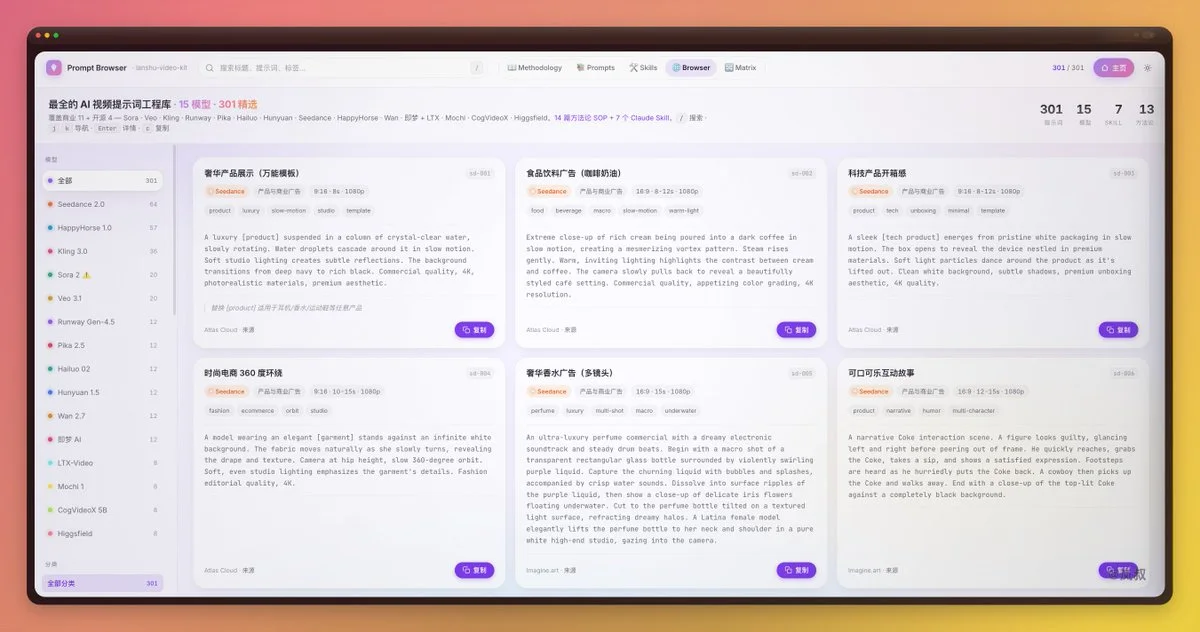
Prompt Browser — 411 条 prompt 的浏览器。15 个模型一人一种发光颜色。三维筛选(模型 + 分类 + 标签多选)。URL 状态可分享,#model=kling-3.0&tags=anime,rain 一份链接发出去对方看到的是过滤好的视图。键盘导航:/ 搜索、j/k 上下翻、Enter 看详情、c 一键复制。
Cross-Model Matrix — 110 条对照基准的横向可视化。10 个场景 tab,每个 cell 给写法说明和可复制 prompt。预留了实测视频槽位 — 等社区贡献视频填进来,这份矩阵就活了。
Markdown Viewer — 把仓库里所有 .md 文件渲染成漂亮 web 文档。自动 TOC、breadcrumb、代码高亮、暗/亮主题。一行启动:
python3 serve.py 8000
八、怎么开始用
git clone https://github.com/cclank/lanshu-awesome-ai-video-kit cd lanshu-awesome-ai-video-kit python3 serve.py 8000
浏览器打开 http://localhost:8000/
或者直接进 GitHub 仓库挑你想看的:
-
prompts/ — 411 条 prompt
-
methodology/ — 14 篇方法论 SOP
-
skills/ — 7 个 Claude Code Skill
-
RESOURCES.md — 15 模型官方文档汇总
-
README.en.md — English README
-
awesome.md — awesome 列表投稿稿
也可打开 lanshu-awesome-ai-video-kit.lank.workers.dev 直接浏览。
GitHub地址: github.com/cclank/lanshu-awesome-ai-video-kit
欢迎大家来Star💗